分类: 技术分享

  • macOS 关闭 SIP 完整教程:系统完整性保护(System Integrity Protection)关闭与恢复

    macOS 关闭 SIP 完整教程:系统完整性保护(System Integrity Protection)关闭与恢复

    什么是 SIP?为什么它比 Gatekeeper 更硬核?

    如果你曾在 macOS 上往 /usr/local 或者 /Applications 写东西被拒,或者装某个内核扩展(Kext)怎么都加载不了,大概率是 SIP(System Integrity Protection,系统完整性保护) 在拦你。它是 Apple 从 macOS 10.11 El Capitan 开始引入的安全机制——本质上就是给整个系统核心区域加了一层“只读 + 代码签名验证”的双重保险。

    SIP 和大家更熟悉的 Gatekeeper 有什么区别?Gatekeeper 检查的是”这个 app 是不是被 Apple 公证过的”,而 SIP 检查的是”有没有人敢碰系统核心“。即使你关掉了 Gatekeeper,SIP 依然会阻止你修改 /System、/usr、/bin 这些目录。

    SIP 到底在保护什么?

    SIP 的保护范围和检查项比大多数人想象的要广。Apple 把它做成了一套可以细粒度配置的安全框架:
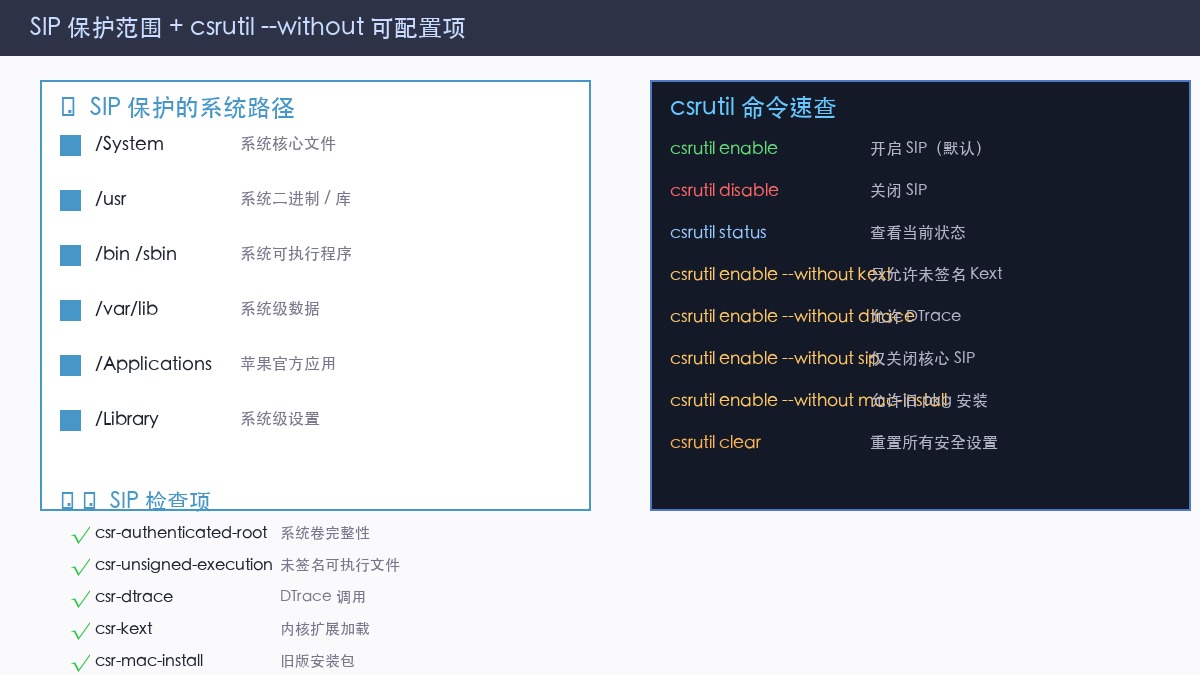
    SIP 保护的系统路径 + csrutil 可配置检查项

    受保护的路径包括:

    • /System — 系统核心文件(几乎不能动)
    • /usr — 系统二进制和库(/usr/local 是唯一的例外)
    • /bin、/sbin — 系统可执行程序
    • /var/lib — 系统级数据目录
    • /Applications 中 Apple 自带的应用
    • 内核扩展(Kext)的加载
    • DTrace 的系统调用(sudo dtrace 会被 SIP 拦)

    SIP 还会验证所有加载到内核空间的代码签名——任何未签名的 Kext 在开启 SIP 的 Mac 上都会直接被拒绝。

    为什么要关掉 SIP?常见场景

    老实说,大部分人不应该关掉 SIP。但确实有一些场景你可能需要它暂时处于关闭或部分关闭状态:

    1. 开发驱动 / 内核扩展(Kext):Apple Silicon 上没签名的 Kext 根本加载不了;Intel 上虽然可以加载但会被 Gatekeeper 警告,SIP 关掉才能完全绕过。
    2. 修改系统级配置:比如自定义系统字体、改系统声音、修改系统级 plist 文件(/Library/Preferences 下的)。
    3. 逆向工程 / 安全研究:需要用 DTrace、Frida、lldb 对系统进程做调试。
    4. 安装旧版 .pkg 安装包:macOS 11+ 要求新的 notarization 流程,老 pkg 可能需要关 SIP 才能装。
    5. 硬件 Hack / 模拟器:某些旧的 PC 模拟器、USB 设备驱动需要关 SIP 才能正常工作。
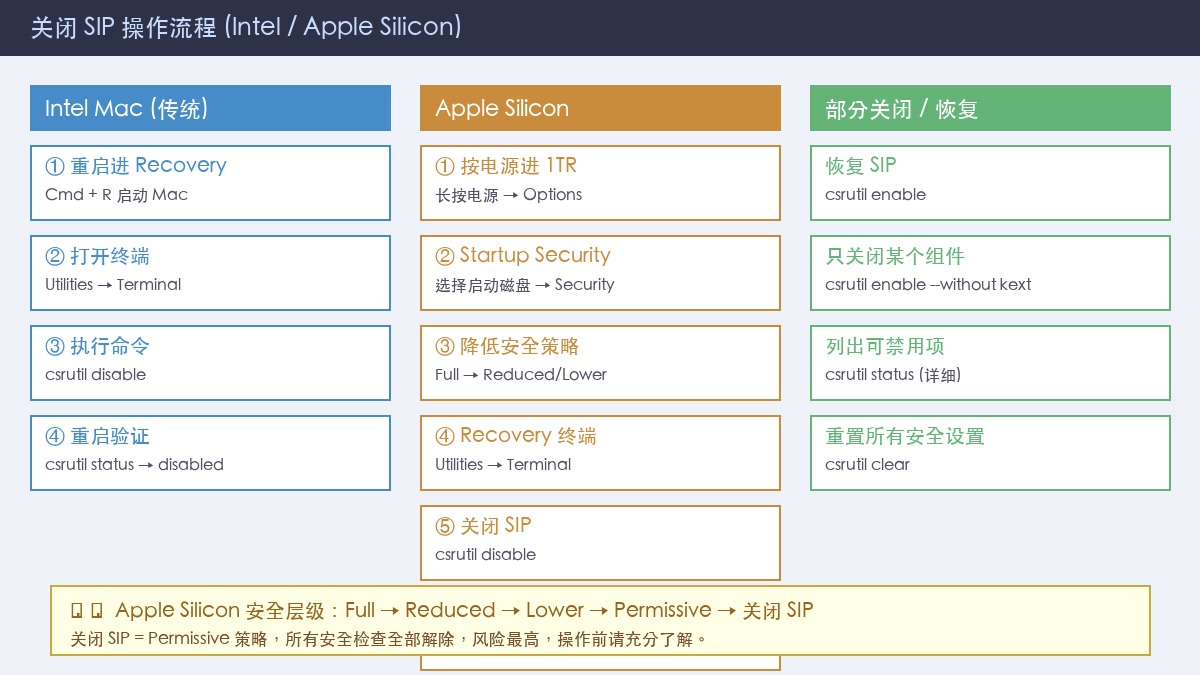
    关闭 SIP 操作流程:Intel vs Apple Silicon 对比

    完整教程:Intel Mac 关闭 SIP

    Intel Mac(所有 2020 年以前的 Mac)操作相对简单,因为 NVRAM 里还能存 SIP 配置:

    # 0. 先看一下当前状态
    csrutil status
    # System Integrity Protection status: enabled.
    
    # 1. 进入 Recovery Mode
    #    关机 → 开机时立即按住 Command (⌘) + R
    #    看到 Apple Logo 后松开
    
    # 2. 打开终端
    #    菜单栏 → Utilities (实用工具) → Terminal (终端)
    
    # 3. 关闭 SIP
    csrutil disable
    # 系统提示:
    # Successfully disabled System Integrity Protection.
    # Please restart the machine for the changes to take effect.
    
    # 4. 重启
    reboot
    
    # 5. 验证
    csrutil status
    # System Integrity Protection status: disabled.

    完整教程:Apple Silicon (M1/M2/M3/M4) 关闭 SIP

    Apple Silicon 完全不同——SIP 配置不再存 NVRAM,而是走 LocalPolicy(签名策略文件)。而且 Apple Silicon 有完整的安全层级(Security Policy Levels),在关闭 SIP 之前可能需要先降级:

    # 0. 先确认当前策略
    csrutil status
    # System Integrity Protection status: enabled.
    # (Custom Configuration)
    
    # 1. 进入 RecoveryOS (也称 1TR = One True Recovery)
    #    关机 → 按住电源键不放
    #    看到 Startup Options (启动选项) 后松开
    
    # 2. 降低安全策略(关键步骤!)
    #    在 Startup Options 界面:
    #    a) 选择你的启动磁盘(Macintosh HD)
    #    b) 按住 Shift + Control + Option + Command
    #    c) 同时点击 "Continue" / "继续"
    #    d) 在 Startup Security Utility 中:
    #       Full Security → Reduced Security → Lower Security
    #       (每次降级需要 SIP 关闭状态作为前提)
    #    e) 或者直接在 Recovery 终端用命令:
    #       csrutil authenticated-root disable  # 允许修改系统卷
    #       csrutil enable --without sip        # 仅关闭核心 SIP
    
    # 3. 从 RecoveryOS 打开终端
    #    Utilities → Terminal
    
    # 4. 关闭 SIP
    csrutil disable
    
    # 5. 如果需要禁用更多安全检查(Apple Silicon 特有)
    csrutil authenticated-root disable    # 关闭系统卷完整性校验
    csrutil amfi disable                 # 关闭 AMFI (Apple Mobile File Integrity)
    
    # 6. 重启 & 验证
    reboot
    csrutil status

    恢复 SIP:怎么关的就怎么开

    这个很重要——**用就了记得开回来**。恢复 SIP 和关闭的流程完全一样,只是命令换成 enable:

    # Recovery Mode 里执行
    csrutil enable                        # 完全恢复
    csrutil enable --without kext         # 部分恢复(允许未签名 Kext)
    csrutil clear                         # 重置所有安全配置(恢复出厂)
    
    # 重启后验证
    csrutil status
    # System Integrity Protection status: enabled.

    进阶:部分关闭 SIP,只关需要的那部分

    Apple 把 SIP 做成了模块化的,你可以只关闭特定检查项,而不是全部关掉——这对开发者来说更安全:

    # 列出所有可配置项
    man csrutil  # 搜索 --without 参数
    
    # 常用场景
    csrutil enable --without kext            # 允许未签名内核扩展
    csrutil enable --without dtrace          # 允许 DTrace 调用
    csrutil enable --without mac-install     # 允许旧版 pkg 安装
    csrutil enable --without sip             # 关闭核心 SIP 但保留其他检查
    csrutil enable --without filesystem-protection  # 允许写受保护路径
    
    # 组合多个排除项
    csrutil enable --without kext --without dtrace

    ⚠️ 注意:部分关闭 SIP 也需要在 Recovery Mode 里操作,不能在正常系统里 sudo csrutil disable xxx。

    关闭 SIP 后的安全影响(真的很严重)

    Apple 为什么把 SIP 设计成”必须进 Recovery 才能改”?因为关掉它之后:

    • 恶意软件可以直接修改系统核心文件,杀毒软件根本拦不住
    • 任何进程都可以调用 dtrace、ptrace,敏感数据可能被窃取
    • 未签名的 Kext 可以随便加载,一个恶意 Kext 就是最高权限 RCE
    • macOS 更新的系统卷签名校验会失效,更新可能失败或损坏
    • Apple Silicon 上关掉 SIP = Permissive Security,Secure Enclave 的一些功能也会降级

    忠告:如果只是想装个破解软件或者改个系统主题——别关 SIP,那不值得。如果是开发驱动/逆向工程——用 SIP 的部分关闭(--without kext / --without dtrace),比全关安全得多。

    常见问题 FAQ

    Q: 关掉 SIP 之后 macOS 更新还能装吗?
    A: 能装,但更新过程可能会重新开启 SIP 或验证系统卷完整性。如果系统卷被改过,更新可能失败或触发 Recovery 要求你重新安装 macOS。建议更新前先恢复 SIP。

    Q: 关闭 SIP 会影响 Time Machine 备份吗?
    A: Time Machine 本身还能工作。但 SIP 保护的文件在备份恢复时可能有问题(取决于系统版本和恢复方式)。

    Q: csrutil disable 之后重启了,但 csrutil status 还是 enabled?
    A: Apple Silicon 用户——你忘了在 Startup Security Utility 里降级安全策略!先把 Full Security 降到 Reduced,再去 Recovery 终端执行 csrutil disable。Intel 用户——确认是在 Recovery Mode 里执行的,不是正常系统里。

    Q: Homebrew 和 SIP 什么关系?
    A: Homebrew 是 SIP 设计的”特例”——/usr/local 从一开始就不受 SIP 保护。Apple Silicon 上 Homebrew 装在 /opt/homebrew,也是 SIP 白名单。装 Homebrew 不需要关 SIP。

    适用版本:macOS 10.11 El Capitan 至 macOS 15 Sequoia。Intel 和 Apple Silicon(M1/M2/M3/M4)均已验证。
  • Linux 系统扩容分区及文件系统完整指南:从磁盘到 ext4/xfs 的实操步骤

    Linux 系统扩容分区及文件系统完整指南:从磁盘到 ext4/xfs 的实操步骤

    为什么需要扩容?磁盘空间告急的常见场景

    服务器运维中最常见的告警之一就是 “No space left on device”。无论是虚拟机的虚拟磁盘扩了容、云主机的云盘升级了规格,还是物理服务器插了新硬盘,最终都要面对同一个问题:如何让操作系统真正使用上这些新增的空间?

    很多人以为给虚拟机加了磁盘、或者在云平台点了”扩容”按钮就完事了——其实这只是完成了 L0(物理层) 的扩容,还需要逐层往上走,让分区表、LVM、文件系统都知道”我变大了”。

    先搞懂:Linux 存储的五层架构

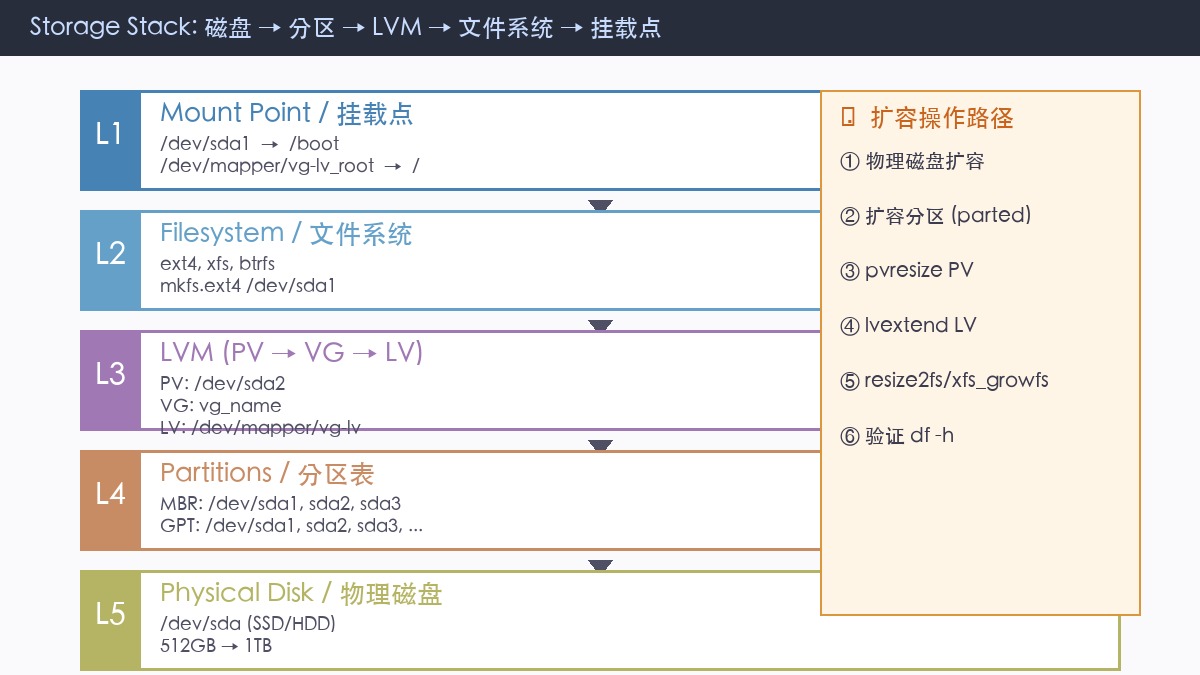
    在动手扩容之前,必须搞清楚数据是怎么一层一层存到磁盘上的。简单来说,一条完整的存储栈长这样:

    Linux 存储层级架构图 - 物理磁盘 → 分区 → LVM → 文件系统 → 挂载点

    1. L1 物理磁盘:/dev/sda、/dev/vda、/dev/nvme0n1 —— 实实在在的硬件,扩容的起点。
    2. L2 分区表:MBR(最多 4 个主分区,2TB 上限)或 GPT(128 分区,无容量限制),把磁盘切成若干块。
    3. L3 LVM(可选但推荐):PV(物理卷)→ VG(卷组)→ LV(逻辑卷),动态管理空间的神器。
    4. L4 文件系统:ext4、xfs、btrfs,决定了数据怎么组织。
    5. L5 挂载点:/、/boot、/home,目录到设备的映射。

    扩容就是要确认每一层都知道”空间变大了”——少一层都不行。

    场景一:LVM 逻辑卷扩容(最常见,强烈推荐)

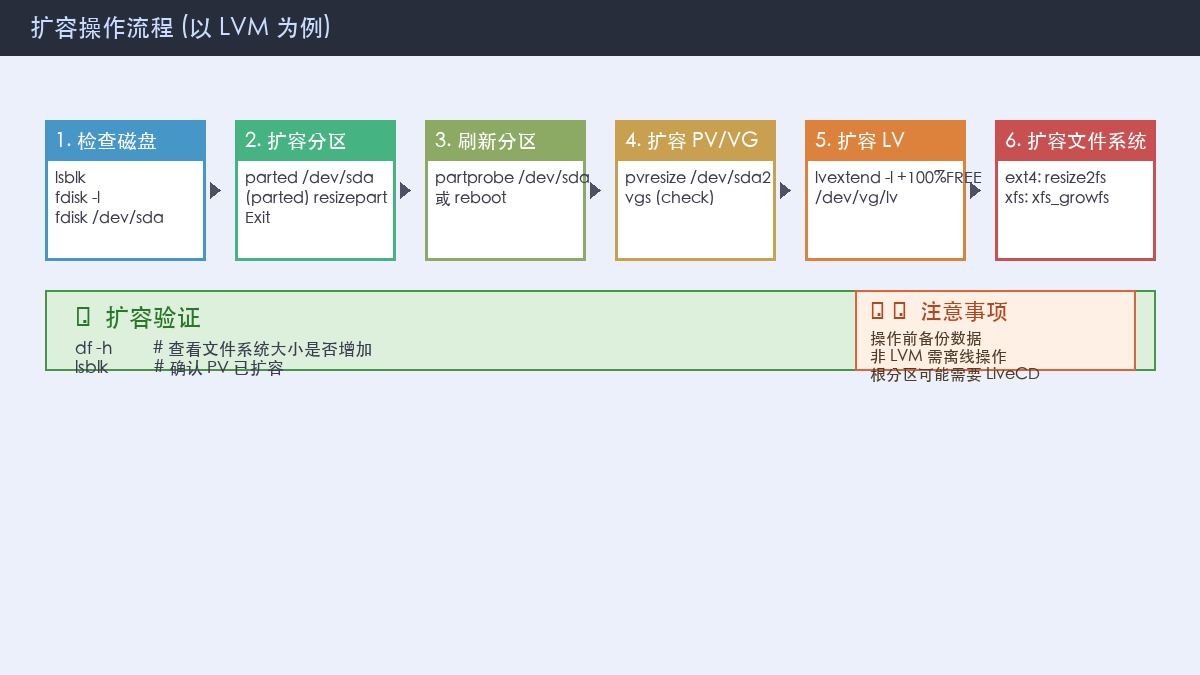
    如果你的系统用了 LVM(绝大多数现代发行版的默认选择),恭喜你——这是最灵活的方案。完整操作流程如下:

    LVM 扩容 6 步操作流程图

    Step 1:检查当前状态

    # 看磁盘布局
    lsblk
    # 看分区
    fdisk -l /dev/sda
    # 看 LVM 状态
    pvs; vgs; lvs
    # 看文件系统使用率
    df -h

    Step 2 & 3:扩容分区表

    假设 /dev/sda2 是 LVM PV 所在分区,磁盘已经从 50GB 扩到了 100GB:

    parted /dev/sda
    (parted) print                 # 记住分区编号 (假设是 2)
    (parted) resizepart 2 100%    # 把 2 号分区扩到磁盘末尾
    (parted) print                 # 确认
    (parted) quit
    # 刷新内核分区表(避免 reboot)
    partprobe /dev/sda

    Step 4:扩容 PV(物理卷)

    # 让 LVM 知道 PV 变大了
    pvresize /dev/sda2
    # 确认 VG 空闲空间增加了
    vgs
    # 输出应该显示 VFree 变大了

    Step 5:扩容 LV(逻辑卷)

    # 把 VG 所有空闲空间都给 LV
    lvextend -l +100%FREE /dev/vg_name/lv_root
    # 或者指定大小
    lvextend -L +50G /dev/vg_name/lv_root

    Step 6:扩容文件系统

    最后一步,让文件系统使用新增的空间:

    # ext4 (最常见) —— 在线扩容,无需卸载
    resize2fs /dev/vg_name/lv_root
    
    # xfs (CentOS/RHEL 默认) —— 挂载点路径,不是设备
    xfs_growfs /
    
    # btrfs
    btrfs filesystem resize max /
    # 验证
    df -h
    # 应该看到 / 的 Size 变大了 ✓

    场景二:非 LVM 原生分区扩容(ext4)

    如果系统没有用 LVM,直接在分区上做了文件系统(简单但不灵活)。这种情况 ext4 支持在线扩容,比缩容容易得多:

    # 1. 用 parted 扩容分区表(同上)
    parted /dev/sda resizepart 1 100%
    partprobe /dev/sda
    
    # 2. 直接 resize2fs
    resize2fs /dev/sda1
    
    # 3. 验证
    df -h

    注意:非 LVM 方案中,分区必须是磁盘上的最后一个分区才能用 parted 在线扩容。如果根分区在中间位置,需要用 LiveCD/USB 离线操作。

    场景三:xfs 文件系统扩容

    xfs 是 RHEL/CentOS 7+ 的默认文件系统,和 ext4 的关键区别是:

    • xfs 只支持扩容,不支持缩容(缩容需要备份→重建→恢复)
    • xfs_growfs 用挂载点路径而不是设备名
    • 扩容需要挂载状态(在线扩容)
    # LVM 部分和 ext4 完全一样
    pvresize /dev/sda2
    lvextend -l +100%FREE /dev/vg/lv_root
    
    # xfs 文件系统扩容(注意是挂载点 / ,不是 /dev/vg/lv_root)
    xfs_growfs /
    # 或者 -d 选项指定数据块大小
    xfs_growfs -d /
    
    # 验证
    df -h
    xfs_info /

    场景四:根分区(/)扩容的特殊处理

    根分区的特殊之处在于:它一直在使用中,大多数情况下是可以在线扩容的(LVM + ext4/xfs 都支持),但如果是非 LVM + 需要缩容,就麻烦了:

    组合 能否在线扩容 备注
    LVM + ext4 ✅ 直接在线 最推荐
    LVM + xfs ✅ 直接在线 RHEL/CentOS 默认
    非 LVM + ext4 ⚠️ 分区表需离线 resize2fs 可在线
    非 LVM + xfs ⚠️ 同上 xfs 不支持缩容

    对于非 LVM + 根分区的情况,最安全的做法是用 LiveCD:

    # 1. 用 LiveCD/USB 启动
    # 2. 挂载原根分区到 /mnt
    mount /dev/sda2 /mnt
    
    # 3. 用 parted 扩容分区表(离线更安全)
    parted /dev/sda
    (parted) resizepart 2 100%
    
    # 4. 扩容文件系统
    resize2fs /dev/sda2
    
    # 5. 卸载、重启
    umount /mnt
    reboot

    扩容后如何验证?

    # 1. df -h 看大小
    df -h /
    # Filesystem     Size  Used Avail Use% Mounted on
    # /dev/sda2      100G   20G   80G  20% /    ← 应该看到 100G
    
    # 2. lsblk 确认分区和文件系统都扩了
    lsblk /dev/sda
    # NAME   MAJ:MIN RM  SIZE RO TYPE MOUNTPOINT
    # sda      8:0    0  100G  0 disk 
    # └─sda2   8:2    0  100G  0 part /          ← 100G ✓
    
    # 3. LVM 专项检查
    lvs            # LV Size 变大了
    vgs            # VFree  = 0 (全部用完了)
    
    # 4. xfs 专项
    xfs_info /
    
    # 5. 跑一个简单的写入测试
    dd if=/dev/zero of=/tmp/test.bin bs=1M count=1000
    rm /tmp/test.bin

    常见坑与避坑指南

    干了 10 年运维,扩容踩过的坑总结:

    1. 忘了 partprobe 或 reboot
    parted 改了分区表后,内核可能还在用旧的。partprobe /dev/sdX 或 blockdev --rereadpt /dev/sdX 让内核重新读分区表。不行就重启。

    2. xfs_growfs 传了设备名而不是挂载点
    xfs_growfs /dev/vg/lv_root ❌ —— 报错 “not a mounted XFS filesystem”
    xfs_growfs / ✅ —— 挂载点路径

    3. MBR 的 2TB 限制
    超过 2TB 的磁盘必须用 GPT。parted 支持 GPT,但如果系统装在 MBR 上又要扩容到 2TB+,就需要 gdisk 转换(⚠️ 高风险)。

    4. 云主机还要先扩容云盘
    AWS(EBS)、阿里云(云盘)、腾讯云(CBS)都要先在控制台扩容磁盘,进系统后还要执行 echo 1 > /sys/class/block/xvda/device/rescan 或重启让内核识别新大小。

    5. 扩容顺序不能反
    ❌ 先 resize2fs 再 lvextend
    ✅ 正确顺序:磁盘→分区→PV→LV→文件系统(从下往上)

    6. btrfs 特殊处理
    btrfs 用 btrfs filesystem resize max /,如果是多设备还需要 btrfs device resize。

    写在最后:为什么强烈推荐 LVM?

    如果你的系统还没用 LVM,而磁盘扩容的场景几乎肯定会遇到,建议花时间迁移到 LVM。LVM 的好处:

    • 在线扩容:不停机就能扩
    • 灵活调整:LV 可以在 VG 内任意移动、分配
    • 快照(Snapshot):扩容前拍一个快照,操作失误秒回滚
    • 多磁盘聚合:多块小磁盘组成一个大 VG

    最后一个忠告:操作前备份数据。哪怕是在线扩容、哪怕是 ext4/LVM,一个断电、一个 OOM、一个命令敲错,都有可能把文件系统搞崩。rsync 一把或者 LVM snapshot 一下,花不了 2 分钟。

    适用系统:RHEL/CentOS 6-9、Ubuntu 18.04-24.04、Debian 10-12、以及主流 Linux 发行版。命令以 GNU parted 和 LVM2 为准。

  • 为什么越来越多的网站开始采用前后端分离?

    为什么越来越多的网站开始采用前后端分离?

    什么是前后端分离?

    在传统的网站架构中,前端页面和后端业务逻辑通常是紧密耦合的。服务器端使用 PHP、Java JSP、ASP.NET 等技术直接渲染 HTML 页面,浏览器拿到的就是最终展示的内容。这种模式被称为服务端渲染(SSR)或单体架构。

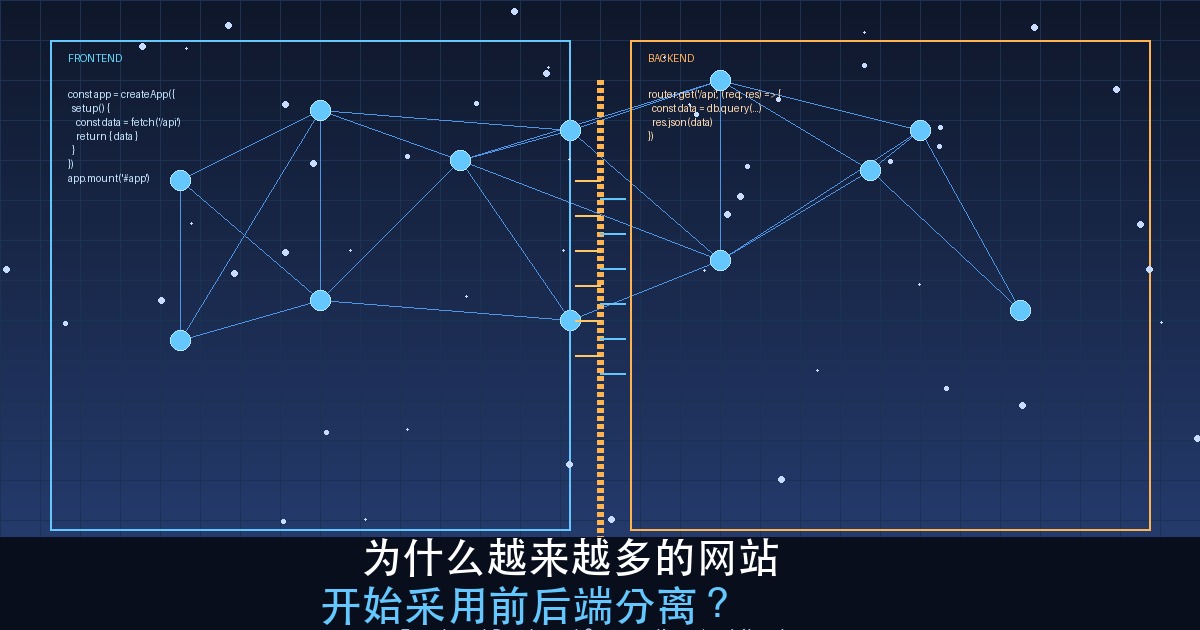
    前后端分离则将前端展示和后端业务彻底解耦:前端(通常是单页应用 SPA)运行在浏览器中,通过 RESTful API 或 GraphQL 向后端请求数据;后端专注于业务逻辑和数据处理,只返回 JSON 等结构化数据,不负责页面渲染。

    架构对比

    传统单体架构:浏览器 → 服务器(页面渲染+业务逻辑+数据库) → 数据库

    前后端分离架构:浏览器(React/Vue) → API 请求 → 后端服务(业务逻辑) → 数据库;同时前端静态资源由 Nginx/CDN 独立承载。

    为什么越来越多的网站选择前后端分离?

    一、开发效率提升

    前后端分离让前后端团队可以并行开发,互不阻塞。前端工程师专注于 UI/UX 和交互体验,后端工程师专注于 API 设计和业务逻辑。双方只需约定好接口规范(如 OpenAPI/Swagger),就能独立推进项目进度。

    根据 2025 年 Stack Overflow 开发者调查,超过 68% 的大型开发团队已经采用了前后端分离架构,其中 82% 的团队报告开发效率有明显提升。

    二、用户体验更好

    单页应用(SPA)使用 AJAX 异步加载数据,页面切换无需整页刷新,只更新变化的部分。这带来了接近原生应用的流畅体验:

    • 更快的页面切换:从首页跳到详情页不再需要等待服务端重新渲染
    • 更顺滑的交互动画:过渡效果、加载状态可以完全由前端控制
    • 离线可用:配合 PWA 技术,可以实现一定程度的离线访问

    三、技术选型更灵活

    分离架构让每个层都可以独立选择最合适的技术栈:

    • 前端框架:React、Vue、Angular、Svelte、SolidJS
    • 后端语言:Node.js、Go、Python、Java、Rust、PHP
    • 数据库:MySQL、PostgreSQL、MongoDB、Redis
    • 消息队列:RabbitMQ、Kafka、Redis Streams

    比如前端可以用 Vue 3 + TypeScript,后端用 Go + Gin,数据库用 PostgreSQL,各取所长。甚至后端的不同微服务可以用不同的语言实现。

    四、性能优化空间更大

    前后端分离为性能优化打开了新世界的大门:

    1. 静态资源 CDN 加速:前端构建产物可以部署到全球 CDN,用户就近访问
    2. 服务端渲染(SSR):Next.js、Nuxt.js 等框架支持按需 SSR,兼顾首屏速度和 SEO
    3. 增量静态生成(ISR):页面静态化后按需更新,平衡新鲜度和加载速度
    4. API 网关和缓存:后端可以通过 Nginx、Redis 等对 API 响应做多层缓存
    5. HTTP/2 和 HTTP/3:独立的前端服务器可以更好地利用现代 HTTP 协议特性

    五、更容易扩展和维护

    随着业务增长,单体架构的维护成本会急剧上升。前后端分离后:

    • 独立部署:前端更新不影响后端,反之亦然
    • 微服务友好:后端可以进一步拆分为微服务,按模块独立扩容
    • 故障隔离:前端故障不会拖垮后端,后端某个 API 异常也不会导致整站不可用
    • 按需扩容:促销活动时只需要扩容后端 API 服务,平时则主要靠 CDN 承载前端流量

    六、多端复用

    一套后端 API 可以服务于多种前端:

    • Web 前端(PC + 移动端浏览器)
    • 移动 App(iOS / Android)
    • 小程序(微信、支付宝等)
    • 桌面应用(Electron、Tauri)
    • 物联网设备和第三方集成

    这意味着开发一套 API 就能支撑一个完整的产品矩阵,大幅降低多端开发成本。

    前后端分离的挑战

    前后端分离并非银弹,也带来了一些新的问题:

    SEO 不友好(可解决)

    传统 SPA 是客户端渲染,搜索引擎爬虫可能无法正确抓取内容。但这个问题已经有成熟的解决方案:

    • SSR 框架:Next.js(React)、Nuxt.js(Vue)提供开箱即用的服务端渲染
    • 预渲染:使用 prerender.io 等工具在构建时生成静态 HTML
    • 动态渲染:对爬虫返回预渲染页面,对普通用户返回 SPA

    首屏加载可能变慢

    SPA 需要先下载 JS 框架才能开始渲染,初始白屏时间可能比 SSR 长。解决方案包括代码分割、懒加载、关键 CSS 内联、预加载等技术。

    服务器成本增加

    分离架构通常需要至少两台服务器(前端静态资源 + 后端 API),可能还需要 Nginx 反代、CDN、缓存服务器等,基础设施复杂度和成本会有所上升。

    接口设计要规范

    前后端通过 API 通信,接口变更会直接影响前端。需要建立良好的接口规范(如 RESTful 或 GraphQL)、版本管理机制和文档自动生成流程。

    总结

    前后端分离不是绝对的答案,但对于中大型项目、需要多端支持、追求用户体验和可扩展性的网站来说,它已经成为事实上的标准架构。

    从单体到分离,本质上是用复杂度换取灵活性。当团队规模、业务复杂度、性能要求达到一定阈值时,分离的收益会逐渐盖过其带来的成本。

    未来,随着 AI 辅助开发、边缘计算、Serverless 等技术的成熟,前后端分离的开发体验和运维成本还会持续改善。无论你正在规划新项目还是重构老项目,理解前后端分离的价值和取舍,都是做出正确架构决策的前提。

  • 网站图片到底放哪里?OSS、图床与其他存储方案的使用体验与对比

    网站图片到底放哪里?OSS、图床与其他存储方案的使用体验与对比

    网站做久了,图片存储迟早会变成一个绕不开的问题。文章封面、教程截图、相册和页面装饰图越来越多以后,直接放在网站服务器、使用对象存储(OSS)、接入专用图床,或再搭配 CDN,看起来都能解决问题,但每种方案都有自己的成本和维护负担。

    先说结论:我目前还没有找到一个在价格、速度、管理、稳定性和迁移成本之间都足够理想的方案。下面不是“标准答案”,而是我在折腾不同存储方式时形成的一份阶段性体验。

    我真正关心的,不只是“能不能存”

    图片能上传只是第一步。对于一个长期维护的网站,我更在意下面这些问题:

    • 访问速度:不同地区打开图片是否稳定,首屏会不会被大图拖慢。
    • 成本是否可预估:除了存储空间,还要考虑请求次数、外网流量、CDN 回源和图片处理费用。
    • 上传与管理体验:能否在 WordPress 中直接选择、替换、生成缩略图,而不是频繁切换后台。
    • 图片处理能力:是否支持 WebP、AVIF、按尺寸裁切、质量压缩和自动格式转换。
    • 迁移难度:服务不可用或准备更换供应商时,原图和文章链接能否顺利迁出。
    • 备份与可控性:有没有独立原图备份,是否过度依赖某个平台。

    方案一:对象存储(OSS)

    这里的 OSS 泛指云厂商提供的对象存储,而不是某一家具体产品。它通常按存储量、请求次数和流量计费,再配合自定义域名、CDN、HTTPS 与图片处理服务使用。

    使用感受

    OSS 最大的优点是“像基础设施”。文件结构、访问权限、生命周期、跨域规则和缓存策略都能自己控制,容量也容易扩展。对于访问量逐渐增加的网站,它比把所有图片塞进同一台 Web 服务器更稳妥。

    但它并不是开通后就能直接获得理想体验。实际使用中还要处理 Bucket 权限、自定义域名、证书、CORS、防盗链、CDN 回源、缓存刷新等配置。账单也不只有存储费:小文件请求、外网流量、图片处理和 CDN 都可能成为额外支出。

    • 优点:扩展性好、权限和生命周期可控、适合与 CDN 组合、迁移工具相对成熟。
    • 不足:初始配置较多,费用项目分散,需要自己做好安全、缓存和备份策略。
    • 适合:图片数量较大、访问量稳定增长,并且愿意维护基础设施的网站。

    方案二:专用图床

    图床更像一项面向内容创作者的成品服务。上传后直接得到链接,有些还提供客户端、浏览器扩展、自动压缩、多尺寸图片和全球分发。单纯从“把截图放进文章”这件事看,图床的体验通常最轻松。

    它的问题主要出现在长期使用以后:免费额度可能变化,原图导出能力不一定完善,域名和链接格式由平台决定,批量迁移时也可能需要重新替换文章中的 URL。部分服务还会进行内容审核或限制外链用途,因此不适合把“省事”直接等同于“可长期依赖”。

    • 优点:上手快、上传方便、通常自带分发与压缩,对个人博客友好。
    • 不足:平台依赖较强,规则和额度可能变化,批量迁移与原图管理需要提前确认。
    • 适合:图片规模不大、希望减少配置工作、能够接受平台规则的个人站点。

    方案三:网站本地、自建存储与其他方案

    直接使用 WordPress 媒体库

    图片和文章放在一起,编辑体验最自然:上传、选择、替换、特色图和缩略图都在同一个后台完成。缺点是媒体越来越多后,会占用服务器磁盘、备份空间和迁移时间;如果源站带宽有限,图片访问也会与页面请求争抢资源。

    自建对象存储、NAS 或兼容 S3 的服务

    这类方案的吸引力在于控制权:数据、目录和备份都掌握在自己手里,也可以针对需要配置同步和归档。但控制权的另一面就是维护责任,包括公网访问、安全更新、磁盘健康、异地备份、证书和可用性。它更适合已经有设备和运维习惯的人,而不是为了省一点存储费临时搭建。

    仓库、静态资源服务与混合存储

    少量文档图片可以跟随静态站点或代码仓库部署,版本关系清楚,但大量二进制文件会让仓库膨胀。实际更可行的往往是混合方案:站点保留编辑入口,公开图片通过独立域名分发,原图另做备份。

    几种方案放在一起对比

    对比维度对象存储 OSS专用图床网站本地 / 自建
    上手难度中等,需要配置域名、权限和缓存低,通常上传即可使用本地较低,自建较高
    访问性能配合 CDN 后较好取决于平台线路与节点取决于源站带宽和部署位置
    费用结构存储、请求、流量、处理分别计费套餐或额度更直观,但规则可能变化服务器、磁盘、带宽和维护成本
    管理体验控制力强,日常操作偏技术化通常最好,适合快速发文与站点整合自然,自建维护较重
    迁移自由度较好,但要规划域名和链接差异较大,依赖导出能力数据最可控,但迁移工作自己承担
    长期风险账单与配置复杂度平台策略、额度和服务持续性硬件、带宽、安全与备份责任

    比选择供应商更重要的六个习惯

    1. 上传前先压缩。普通文章图片优先使用 WebP;在观感允许的前提下,把单张图片控制在 500KB 以内。
    2. 保留合理尺寸。不要把相机原图直接用于网页。封面和正文图片按实际展示宽度输出即可。
    3. 使用自己的图片域名。以后更换底层存储时,可以通过 DNS、反向代理或批量映射降低文章改动量。
    4. 原图独立备份。线上可访问文件不是备份,至少保留一份不依赖当前服务商的副本。
    5. 记录替换关系。批量迁移前导出媒体清单,保留旧 URL、新 URL、附件 ID 和文章引用关系。
    6. 检查失败场景。关注链接失效、防盗链误拦截、缓存未刷新、跨域失败以及超额后的处理方式。

    我现在的阶段性结论

    如果只看性能和扩展性,我更倾向于对象存储加 CDN;如果只看写作体验,专用图床明显更轻松;如果最看重控制权,本地媒体库或自建方案又更踏实。但把费用、管理、备份、迁移和日常发布放在一起,但是我暂时还没有找到一个完全适合自己的选择。

    目前更现实的做法,是先建立不依赖某个平台的图片规范:统一尺寸、优先 WebP、控制体积、使用独立域名、保留原图备份。等图片数量和访问规模更明确后,再决定长期落在哪种存储上。这样即使以后更换方案,也不会从零开始。

    存储方案没有绝对最好,真正重要的是:当价格变化、服务中断或需要迁移时,图片仍然在自己手里,文章也还能正常打开。

  • Mac应用程序无法打开或文件损坏的处理方法Mac任何来源开启教程

    Mac应用程序无法打开或文件损坏的处理方法Mac任何来源开启教程

    打开启动台–其他–终端,打开终端;

    然后输入下面的命令按回车键运行,建议你直接拷贝粘贴,以免你输入错命令;

    sudo spctl --master-disable

    输入命令后【回车】,出现【password】输入你电脑的【开机密码】,输入密码后【回车】。

    再打开 “系统设置” – “安全性与隐私” – “安全性” – 允许一下来源的应用程序 – 点击 App Store 与已知开发者选项,然后选择 任何来源

    之后提示输入Mac开机密码再点击修改设置,再点击 允许任何来源确认即可。